How to Read Papers(整理版)
原始资料: How to Read Papers;原始教程 整理说明: 本版本结合原始笔记和可读取的原始教程重排、补全和翻译,保留常用英文术语。原文件保持不变。
内容简要概括
这篇笔记总结了一套阅读 AI research papers 的流程:先 Read Wide,用少量阅读快速建立领域 mental model;再 Read Deep,对关键论文做第一轮深入理解。核心方法是从 SOTA、survey paper、dataset paper 和 related work 入手,逐步收集问题、方法、结果和待补背景知识。阅读第一遍时不追求完全理解,先抓住论文解决的问题、解决路径和实验主结果,再把不懂的概念放入 To Understand List 集中补齐。
Read Wide、Read Deep、SOTA、Abstract、Survey Paper、Related Work、Introduction、Experiment、Conclusion、To Understand List、Papers with Code、Google Scholar、mPLUG、mental model
目录
- 1. 总体思路
- 2. Read Wide:先建立领域地图
- 3. Between Wide and Deep:形成自己的问题感
- 4. Read Deep:对关键论文做第一轮深入理解
- 5. To Understand List:集中补背景知识
- 6. Presentation Reference:讲论文时的结构提醒
- 7. 可复用模板汇总
1. 总体思路
读一个新领域的 AI 论文时,不要一开始就试图把单篇论文读透。更有效的顺序是先宽读,再深读:
Read Wide:快速浏览多个相关材料,建立对问题、数据集、代表方法、评价指标和研究趋势的初步 mental model。Read Deep:挑选关键论文做第一轮深入阅读,重点理解它提出的问题、解决路径、核心实验和结论。To Understand List:遇到不懂的术语、方法、指标或背景论文时先记下来,最后集中补背景知识。
第一遍读论文大概只能理解 10% 是正常的。目标不是一次读懂所有细节,而是让下一轮阅读更有方向。
2. Read Wide:先建立领域地图
Read Wide 的目标是用较低成本了解一个领域的大致轮廓:当前有哪些 benchmark、哪些方法是 SOTA、常见 dataset 是什么、survey paper 如何归纳领域,以及最新论文的 related work 如何描述研究脉络。
2.1 找 SOTA,读 abstract 并总结
可以先从 Papers with Code 或类似 leaderboard 入手,找到当前任务下较新的 SOTA 方法。读对应论文的 abstract 时,不需要马上理解每个 technical term,而是先抽取四类信息:
- 模型的简单介绍:这是什么模型,面向什么任务或能力。
- 解决了什么问题:它认为旧方法的主要瓶颈是什么。
- 用了什么办法解决问题:它提出了什么结构、训练策略或关键机制。
- 达成的最终效果:它在什么 benchmark、dataset 或任务上取得了什么结果。
以原始教程中的 mPLUG 为例,abstract summary 可以写成下面这种结构:
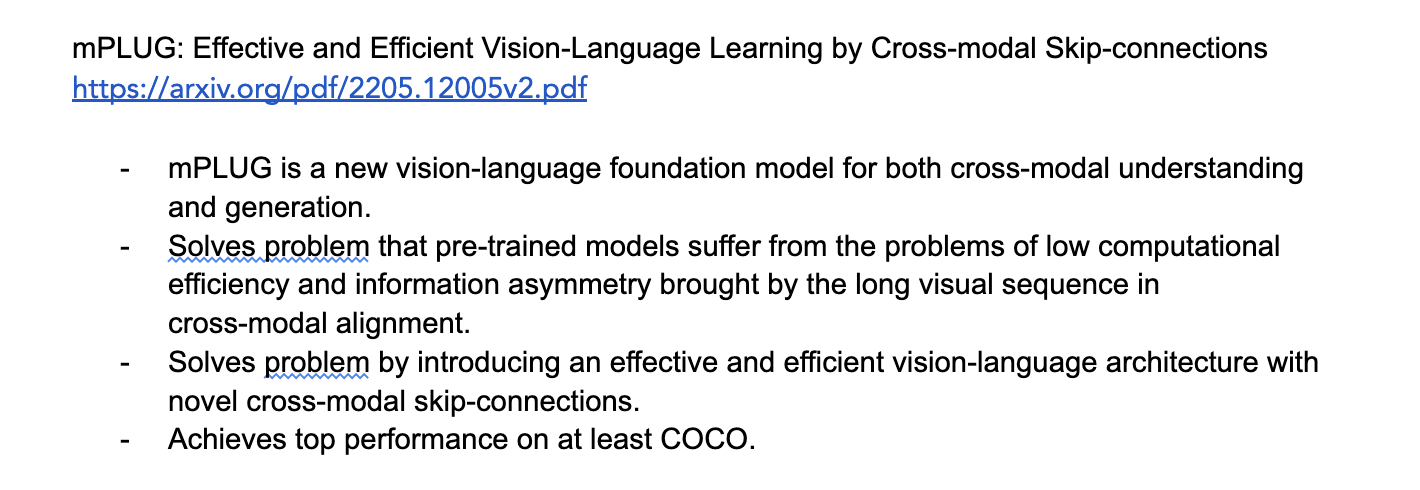
这里的重点不是把 abstract 翻译一遍,而是把摘要压缩成“模型是什么、问题是什么、方法是什么、效果是什么”。如果读到不懂的词,例如 cross-modal alignment、BLEU-4、CIDEr、METEOR、SPICE,先放进 To Understand List。
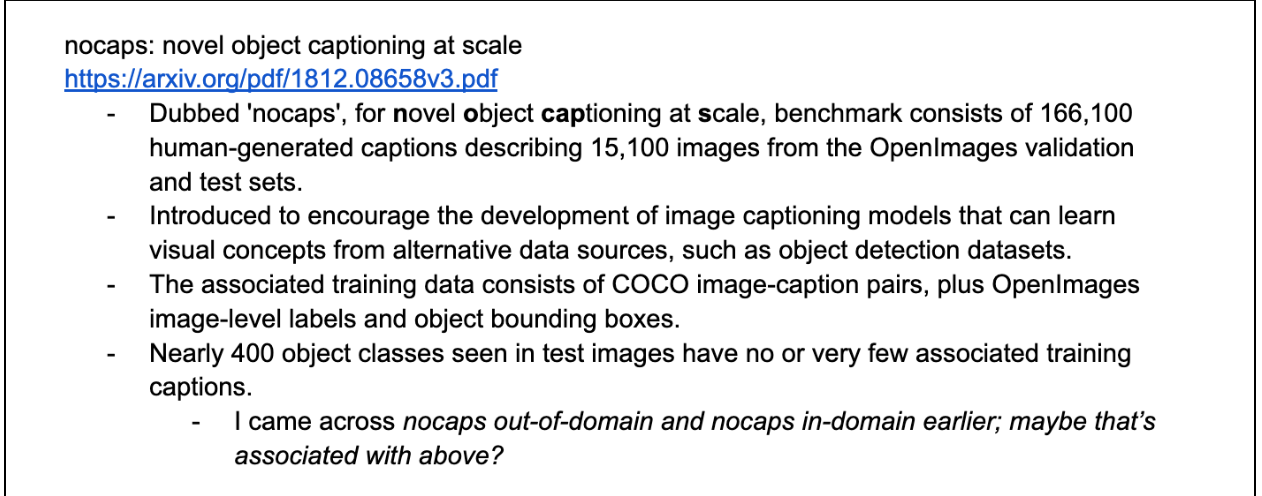
2.2 读 dataset paper 的 abstract
理解 SOTA 方法之后,也要理解它们使用的 dataset。原始教程以 image captioning 为例,先看 nocaps 和 COCO captions:
- dataset 解决什么评测或数据覆盖问题。
- 数据来自哪里,规模大概是什么。
- 任务如何定义输入、输出和评估指标。
- 这个 dataset 为什么会被当前方法反复使用。
dataset abstract 通常比方法论文更容易读,因为很多信息是自然语言描述。读 dataset paper 可以帮助判断某个 SOTA 结果到底是在什么问题设定下取得的。
2.3 找 survey paper,读结构和未来方向
在 Google Scholar 上搜索领域关键词和 survey,优先找较新的 survey paper。对于一篇较长的 survey,不必从头读到尾,可以先读:
- Figure 1:通常给出领域结构、方法分类或任务关系。
- Contributions:看作者认为这篇 survey 的组织方式和新增价值是什么。
Conclusions and Future Directions:快速了解开放问题和未来趋势。
原始笔记中的 survey paper 示例总结了 image captioning 领域的结构、训练策略、评测问题和开放挑战:
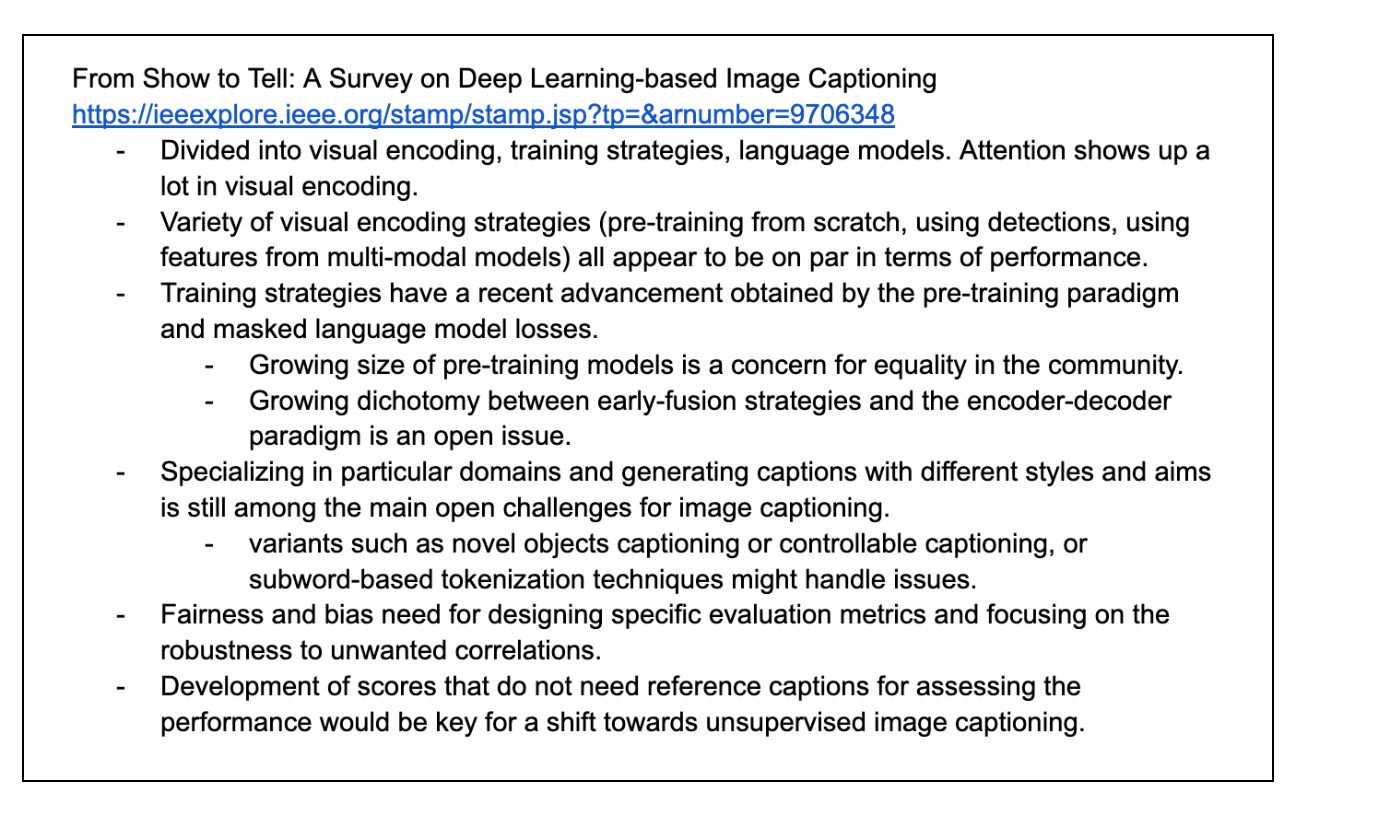
survey paper 的价值在于帮你把零散术语组织成一个领域地图,但它可能不够新,也未必完全覆盖最新 SOTA。因此 survey 适合用来建立背景,不适合直接替代近期论文。
2.4 读 related work,总结研究脉络
完成 SOTA abstract 和 survey paper 之后,再回到第 1 步找到的近期论文,读它们的 related work。related work 常常会说明:
- 领域中传统方法如何分类。
- 旧方法各自解决了什么问题,又留下了什么限制。
- 新方法与已有方法相比,真正的变化在哪里。
- 哪些经典论文应该进入下一轮阅读列表。
下面这张 mPLUG 示例图混合了 abstract 总结和 related work 扩展笔记。整理时可以把前半部分当作第 2.1 节的 abstract summary,把后半部分当作 related work 的研究脉络笔记:
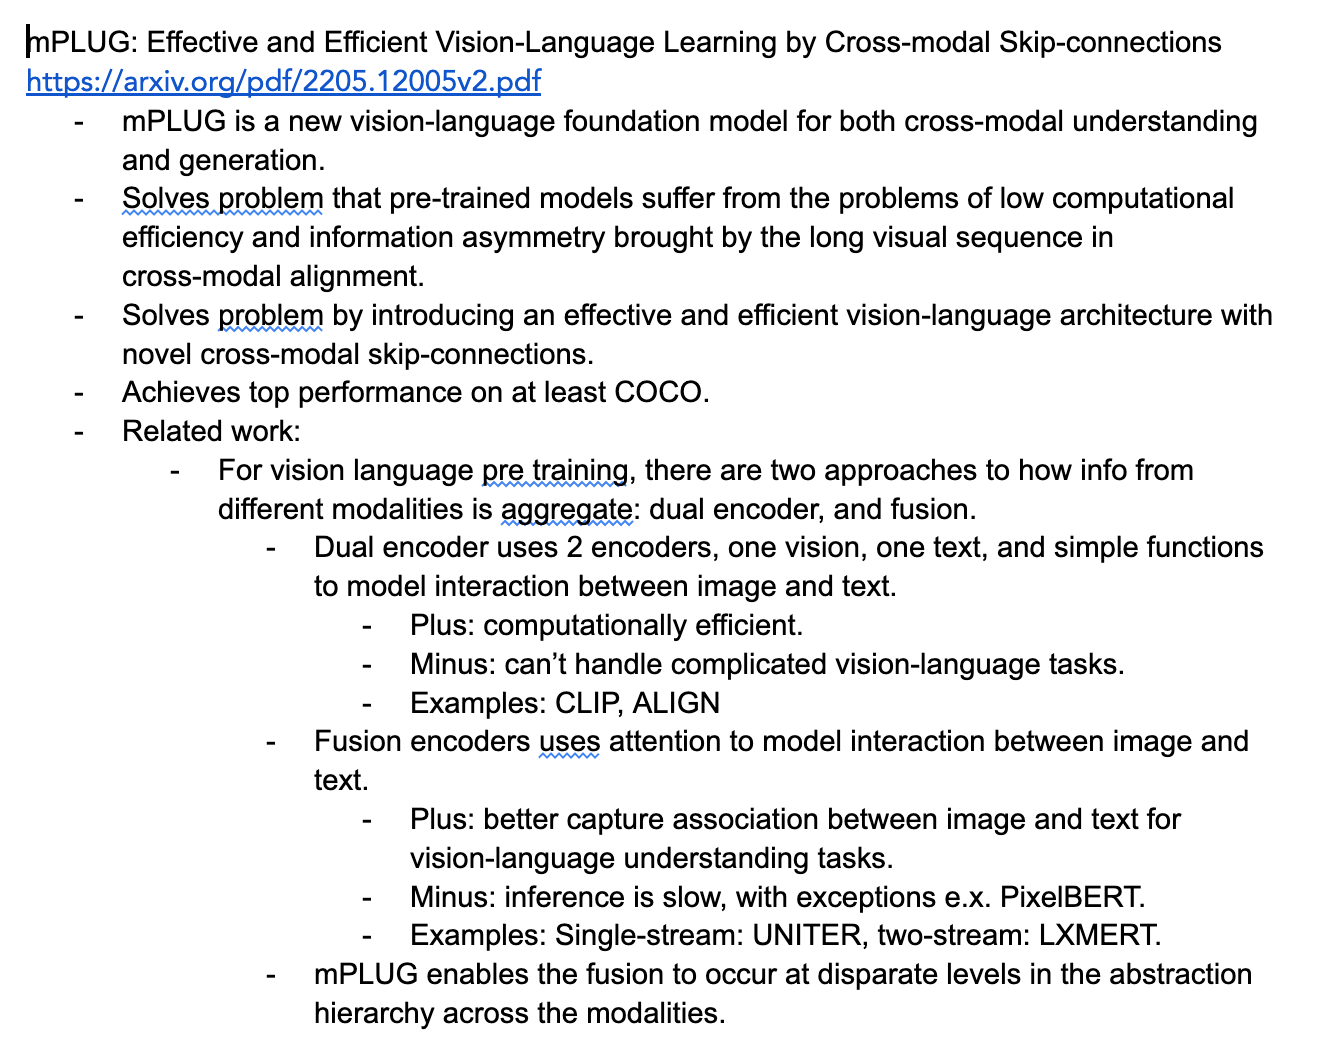
读 related work 时不必查清每一篇引用论文,但要记录反复出现的模型、概念和分类方式。它们通常就是后续补背景知识的入口。
3. Between Wide and Deep:形成自己的问题感
宽读之后,每个人的 notes 都会开始分化。即使读的是同一批材料,不同读者也会对不同术语、问题或方法产生兴趣。这个分化是有价值的,因为它说明你开始建立自己的 mental model。
在进入深读之前,可以先写一段领域总结:
- 这个任务想解决什么问题。
- 当前代表 dataset 和 benchmark 是什么。
- 近期 SOTA 方法大概沿着什么方向改进。
- survey paper 提到的主要挑战和 future directions 是什么。
- 哪些概念或论文仍然不理解,需要放入
To Understand List。
如果某类 SOTA 方法反复出现,例如原始教程中提到的 vision-language pre-training,可以把它标记成下一轮深读的重点。
4. Read Deep:对关键论文做第一轮深入理解
Read Deep 的目标不是一次读懂 100%,而是在已有 mental model 的基础上,逐步理解单篇关键论文的主线。第一轮阅读可以围绕 introduction、figure、experiment 和 conclusion 展开。
4.1 读 introduction,提取 problem-solution chain
先读 introduction,因为它通常比 methods 更面向一般读者。阅读时重点标出:
- 论文要解决的核心问题。
- 过去方案如何解决这个问题。
- 过去方案的限制是什么。
- 本文提出的新方案如何回应这些限制。
- 本文声称的主要 contributions。
原始教程中用 mPLUG 的 introduction 展示了一个 problem-solution chain:论文先描述更一般的问题,再逐层收窄到本文真正解决的问题。
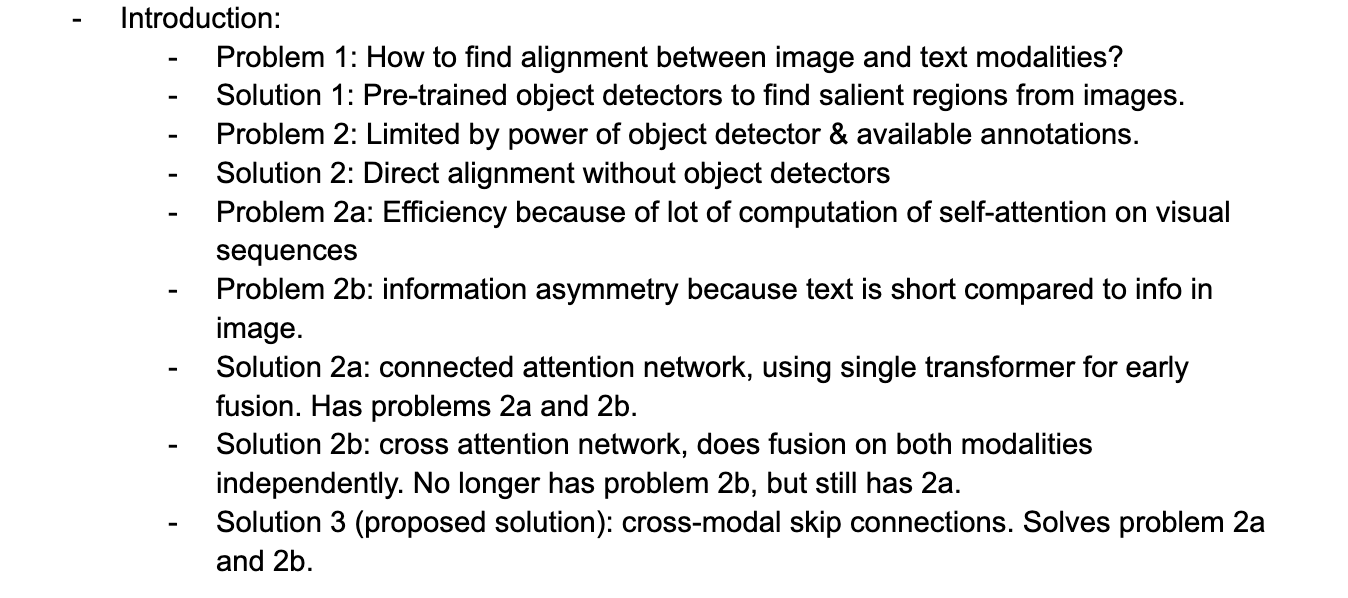
一个好用的做法是给不同信息使用不同 highlight 颜色,例如:
- 黄色:problem/challenge。
- 粉色:solution。
- 橙色:main contribution 或与自己任务最相关的实验信息。
4.2 看 Figure 1 和关键图表
如果论文有 Figure 1 或 architecture overview,优先看它。好的图能帮助你理解:
- 方法的输入输出是什么。
- pipeline 或 model architecture 如何分块。
- 本文方法与 baseline 的主要差异在哪里。
- abstract 和 introduction 中的关键术语分别对应图中的哪一部分。
遇到 methods 部分读不懂时,不必硬啃所有公式和细节。可以先借助 figure、algorithm pseudocode 和 section headings 建立粗略结构。
4.3 选择性读 methods 和 experiments
methods 部分通常需要大量背景知识,第一轮可以只读对当前问题最有帮助的部分。读 experiments 时,优先看:
- data setup:用了哪些 dataset,训练/测试如何划分。
- main table of results:主要 benchmark 上比了哪些 baseline,提升在哪里。
- 与自己问题相关的 task section。
- 特别新颖或异常的 experiment design。
如果只关心 image captioning,就可以暂时跳过与该任务无关的结果。阅读论文时信息量很大,选择性关注是必要的。
4.4 读 conclusion,回看 abstract 和 introduction
最后读 conclusion。它往往和 abstract、introduction 有相似内容,但读到这里时,你已经对术语和方法有了更多上下文,因此会比一开始更容易理解。
完成第一轮后,可以把论文重新压缩成几句话:
- 本文解决了什么问题。
- 为什么这个问题重要。
- 它相比已有方法改了什么。
- 实验是否支持作者的主张。
- 还有哪些概念或引用论文需要补。
5. To Understand List:集中补背景知识
阅读过程中遇到不懂的名称、指标、论文或技术细节,不要立刻打断主线。先统一加入 To Understand List,读完一轮后再集中处理。
原始笔记中的 mPLUG 示例把不懂的概念和相关引用放在一起,方便后续逐个补背景:
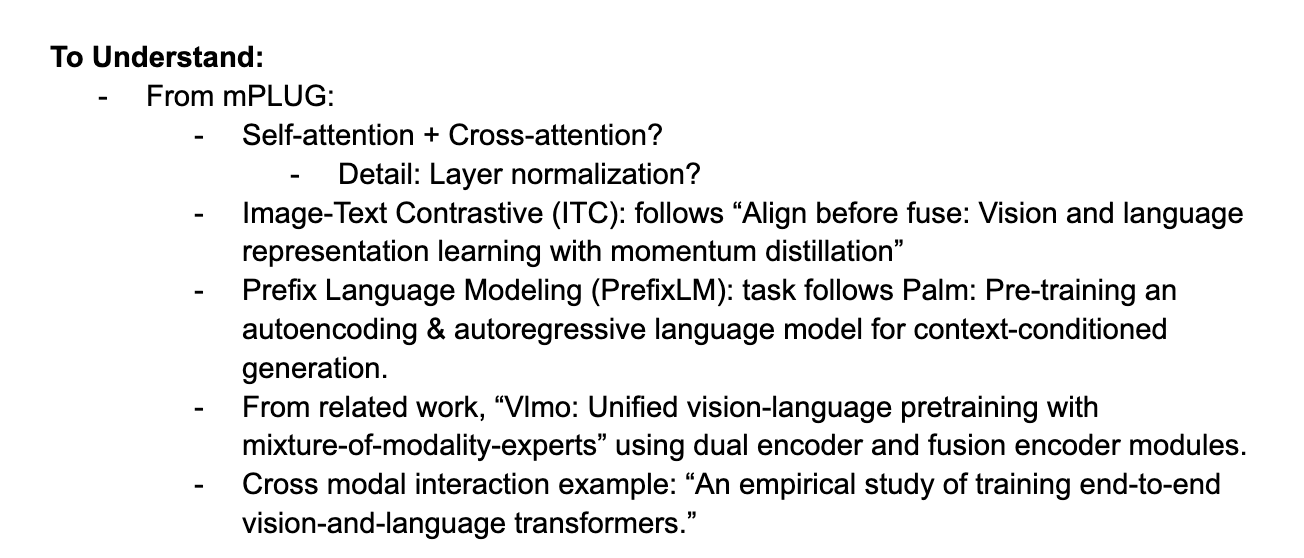
To Understand List 可以包含:
- 术语:例如
self-attention、cross-attention、layer normalization。 - 训练目标:例如
Image-Text Contrastive、Prefix Language Modeling。 - 评价指标:例如
BLEU、CIDEr、SPICE。 - 相关论文:例如 related work 中反复出现的经典方法。
- 自己还说不清的图表、公式或实验设置。
整理这个列表时,可以把最影响理解主线的概念排在前面。不是所有背景都要马上补,先补那些会影响你复述论文核心贡献的内容。
6. Presentation Reference:讲论文时的结构提醒
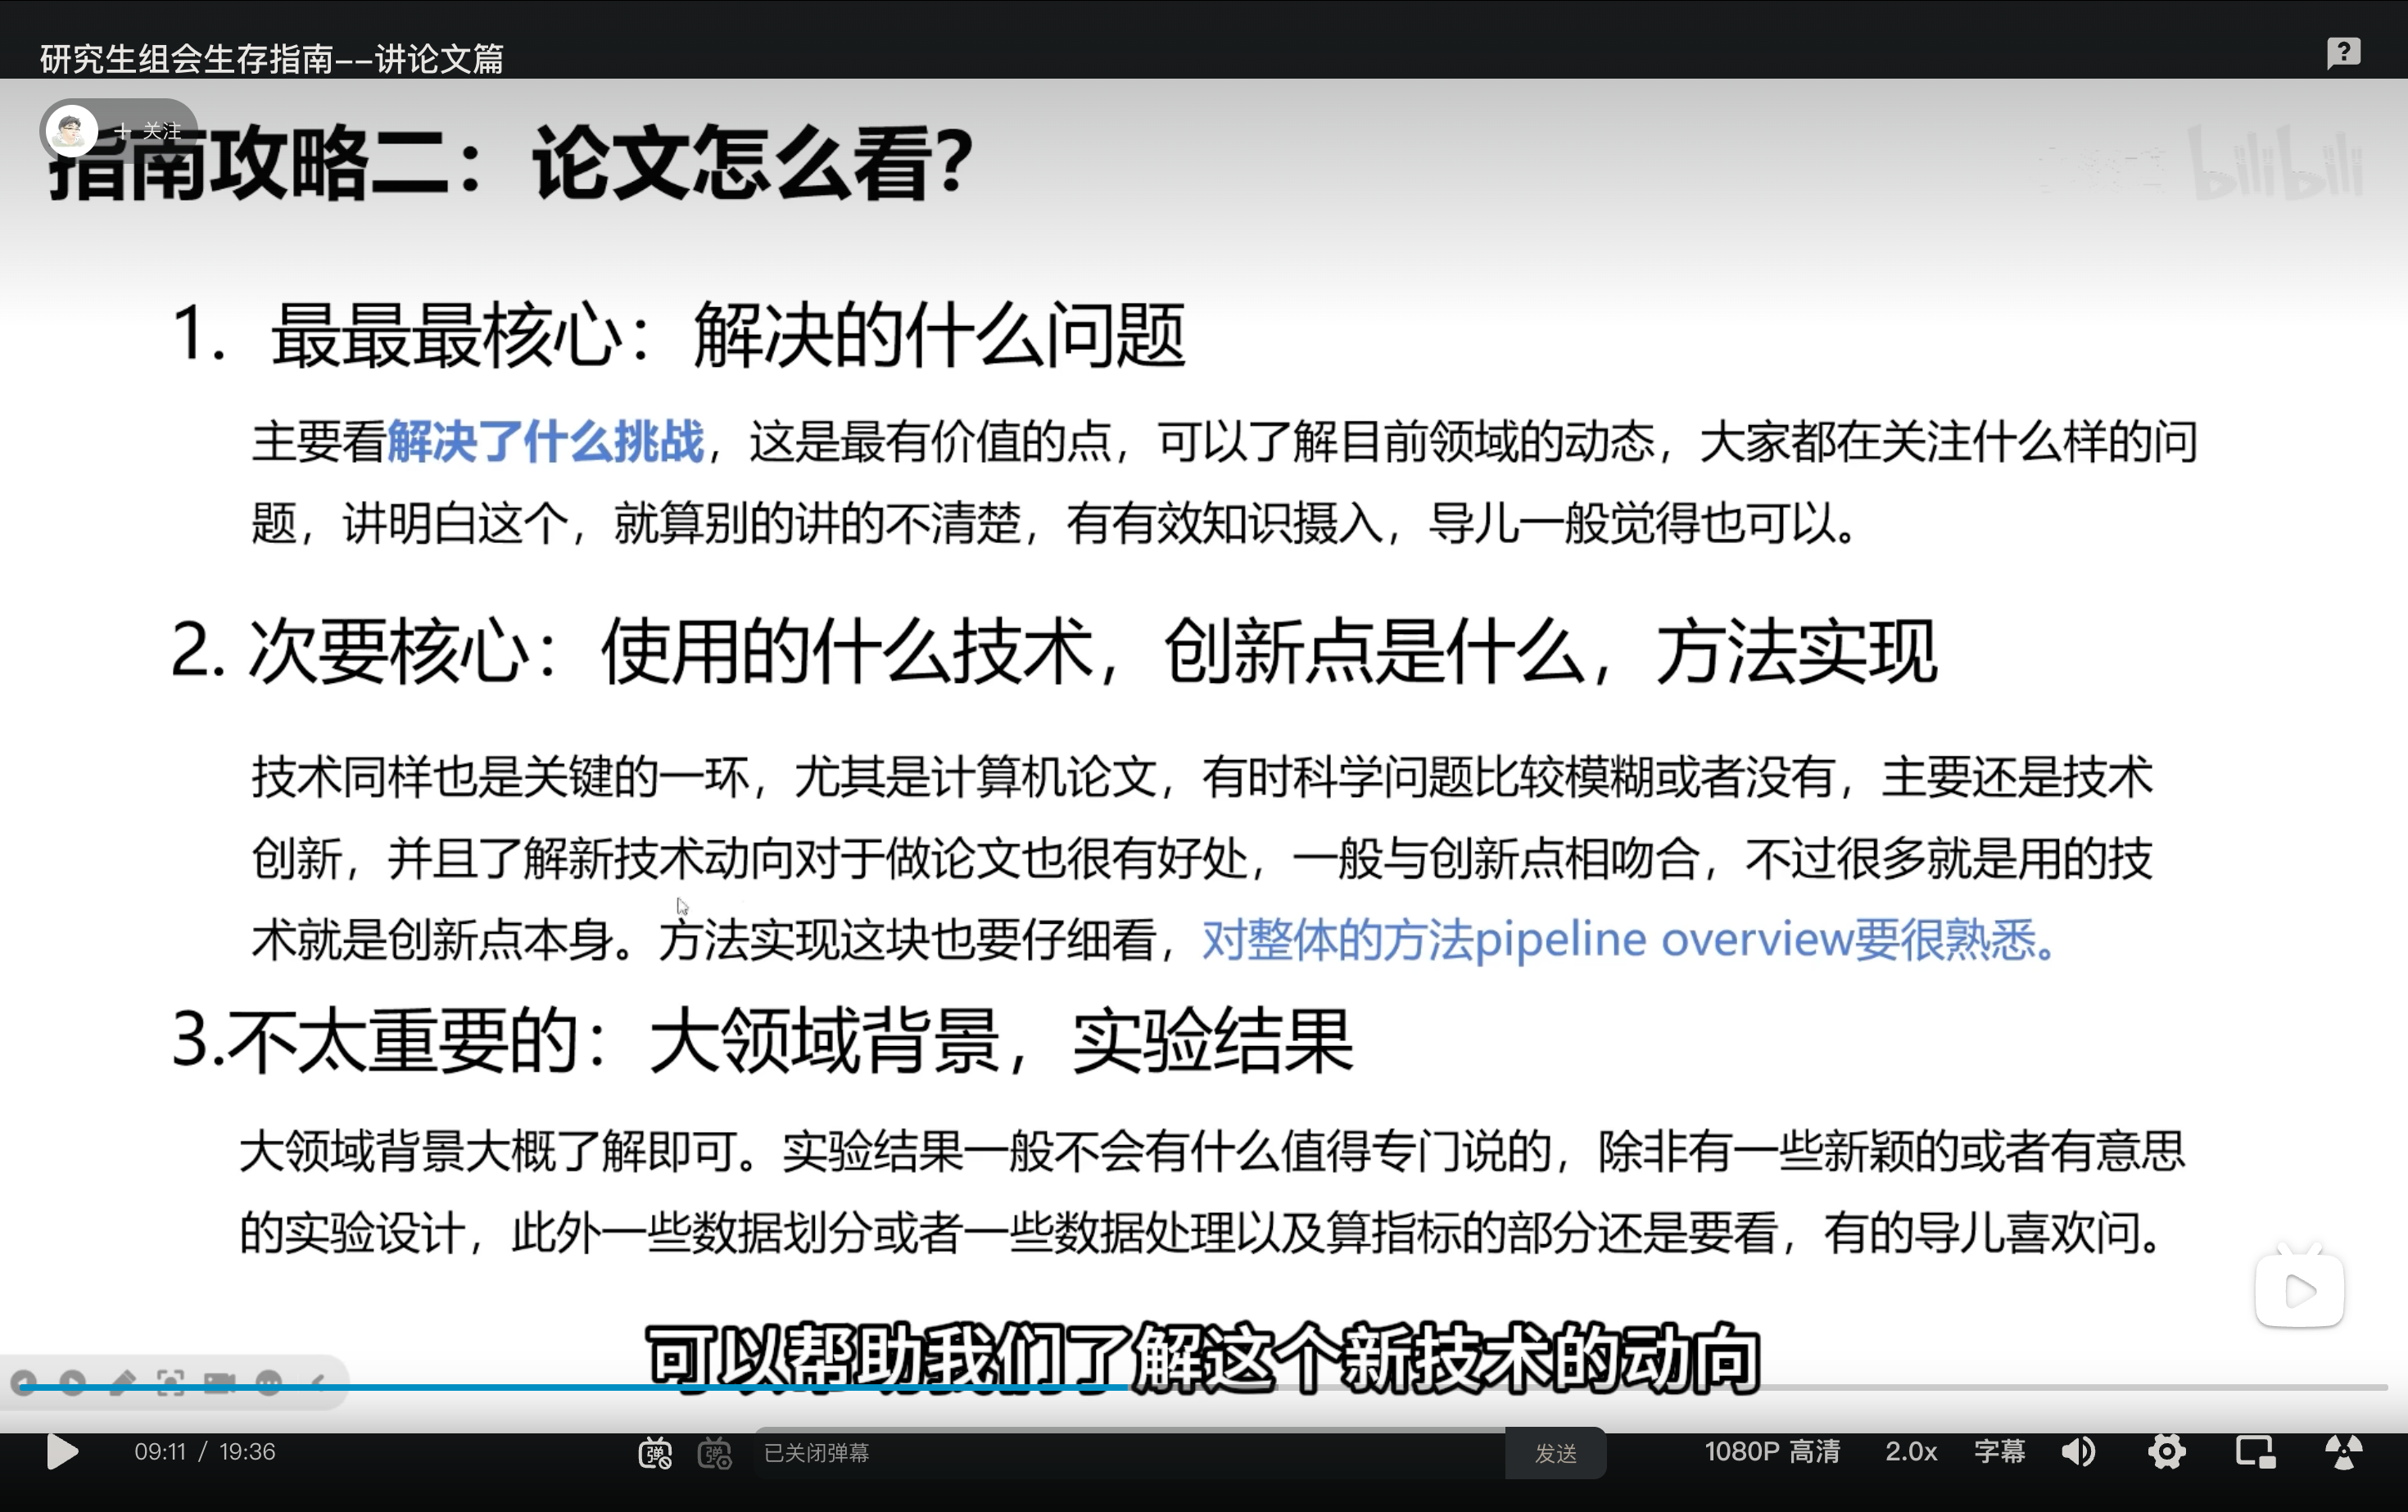
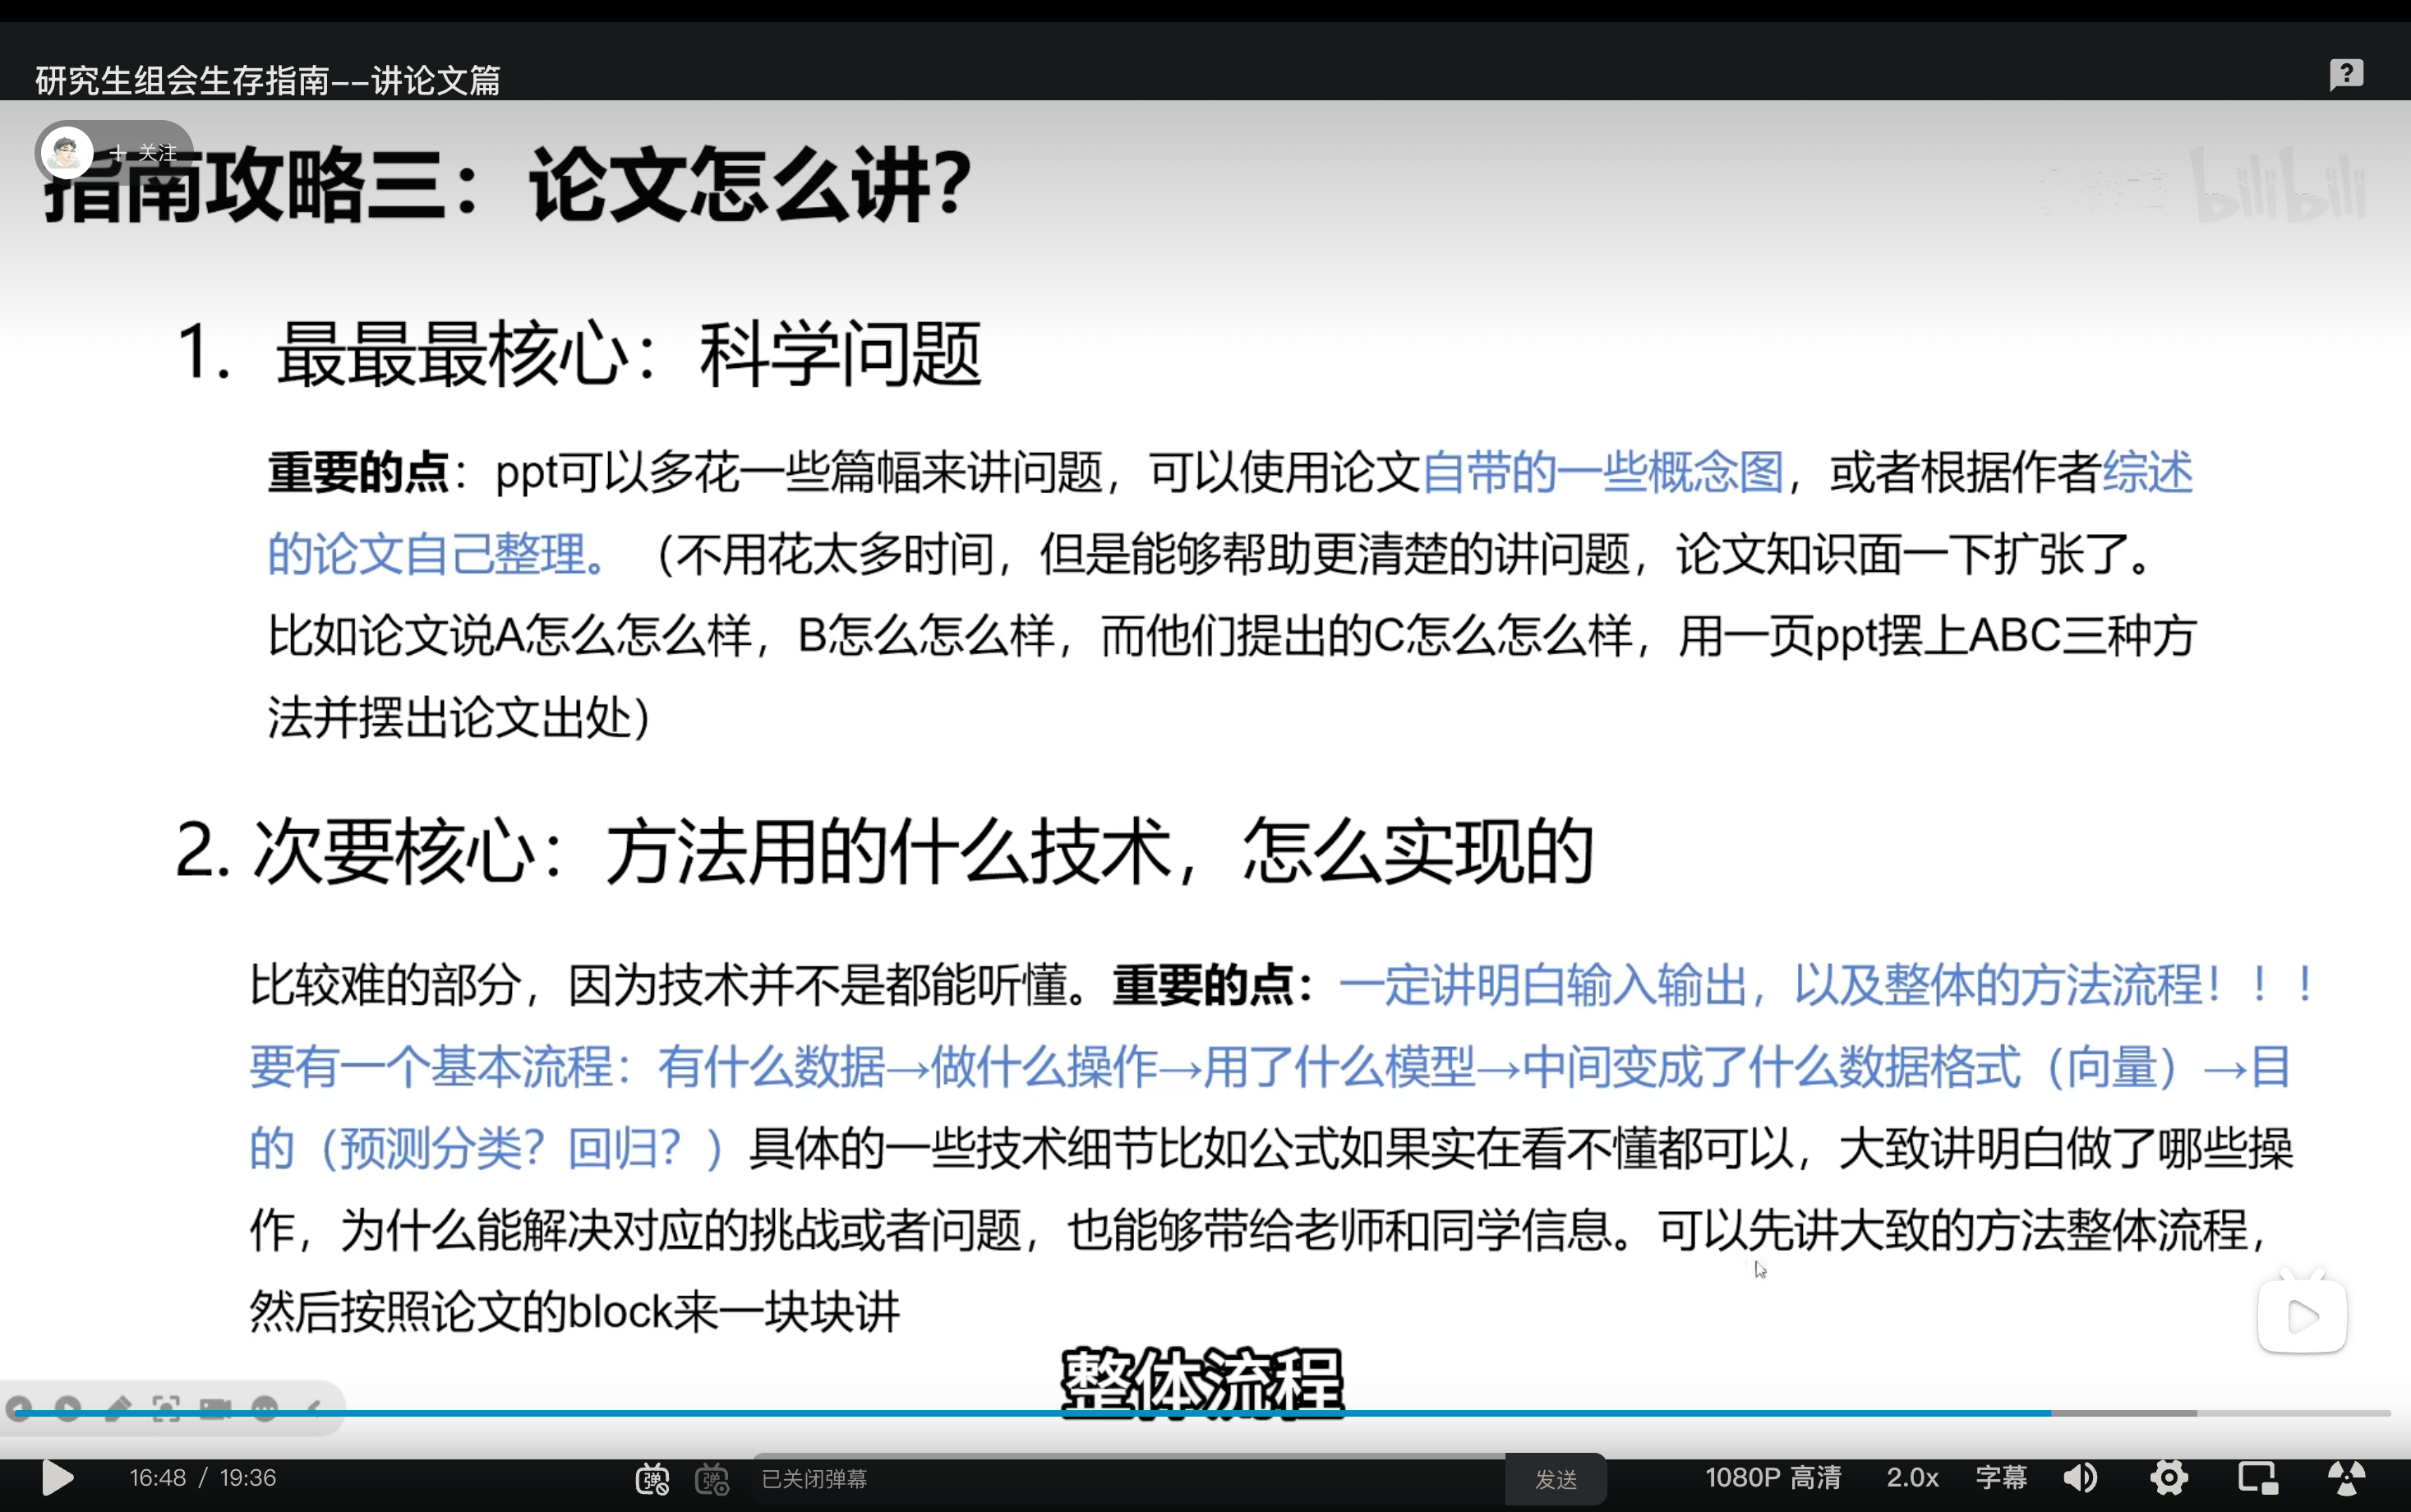
下面两张图来自“论文怎么看/怎么讲”相关参考,适合作为 presentation 时的结构提醒,不属于 Read Wide 或 Read Deep 的主流程。
讲论文时,最核心的是让听众明白论文解决了什么问题,其次才是方法技术和实现细节。大领域背景和实验结果可以讲,但不要让它们淹没主线。
如果要做 PPT,可以多用论文自带的概念图、pipeline overview 或作者综述中的结构图。讲方法时要说明输入输出、整体流程和每一步操作,而不是只堆公式或术语。
7. 可复用模板汇总
7.1 Abstract Summary Template
读 SOTA paper 的 abstract 时,可以按这个模板做最小总结:
### <Paper / Model Name>
- Paper: <link>
- Model: <用 1 句话说明模型是什么。>
- Problem: <它要解决什么问题,旧方法的瓶颈是什么。>
- Method: <它提出什么结构、训练目标、数据策略或关键机制。>
- Result: <它在什么 dataset / benchmark / task 上达到什么效果。>
- To Understand:
- <不懂的术语、指标、引用论文或技术细节。>
7.2 First-Pass Reading Template
对单篇论文做第一轮深读时,可以按这个顺序记录:
## <Paper Title>
### Problem-Solution Chain
- Problem 1:
- Existing Solution 1:
- Limitation:
- Proposed Solution:
### Key Figure / Pipeline
- Input:
- Output:
- Main modules:
- Difference from prior methods:
### Experiments
- Dataset:
- Baselines:
- Main result:
- Metrics to understand:
### Conclusion
- Main takeaway:
- Remaining questions:
### To Understand List
- <concept / paper / metric>